

計測方法
無料で始める3行でいうと
計測で必ず守っている3つのこと
すべての計測値に、モデル名と取得時刻をつけます。
AIが名前を出した「言及」と、引用元に選んだ「引用」を分けて数えます。
判定に足りるデータがないときは、「データ不足」とそのまま表示します。
質問を3つのAIに送る
ChatGPT・Claude・Gemini に同じ質問を送り、モデル名と時刻を記録します。
回答を原文のまま残す
AIの回答(原文)と、示された引用元のURLを保存します。
言及と引用を分けて数える
名前が出ただけの回答と、引用元に選ばれた回答を別に数えます。
計測の条件を添えて表示する
モデル名・取得時刻・くり返し回数・計測の記録番号を値の近くに出します。
計測条件の表示
すべての計測値に、モデル名と時刻をつける
AIはモデルが更新されるたびに回答が変わります。どのモデルで、いつ測ったかが分からないと、数字を比べられません。
Geo Index は、すべての計測値に正確なモデル名(例: GPT-5 nano / Claude Haiku 4.5 / Gemini 2.5 Flash)と計測時刻を表示します。あわせて、モデル更新の頻度をふまえた再計測の目安も案内します。
「引用率が上がった・下がった」という変化を見るときも同じです。比べる相手が同じモデル・近い時期の計測かどうかを、いつでも確認できます。
言葉の定義
「言及」と「引用」を区別する
この2つを混ぜると、対策の優先順位を誤ります。
言及(mention)
AIの回答本文にブランド名が登場すること。
引用(citation)
回答の引用元として自社サイトが使われること。
Geo Index はこの2つを別の指標(言及シェアと、引用をもとにしたシェア)として計測します。言及されていても、引用元になっていないことがあります。
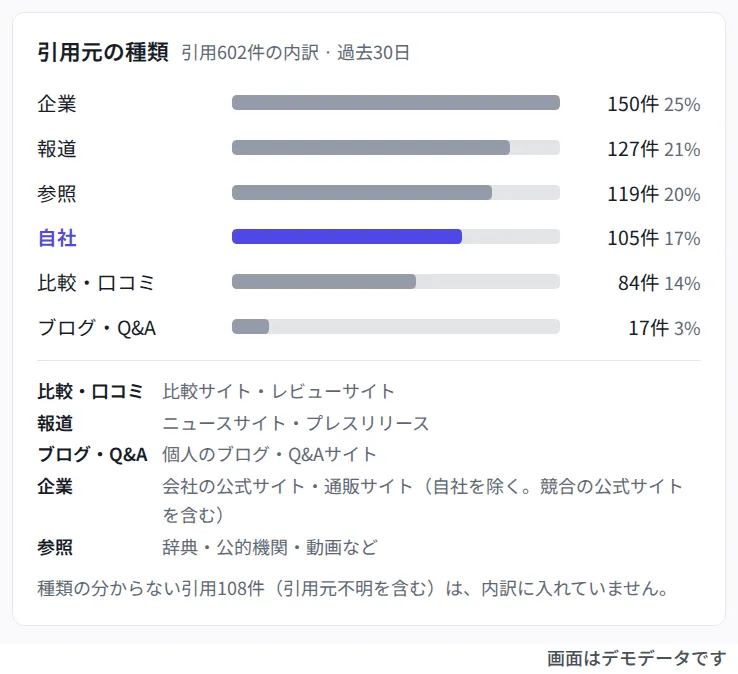
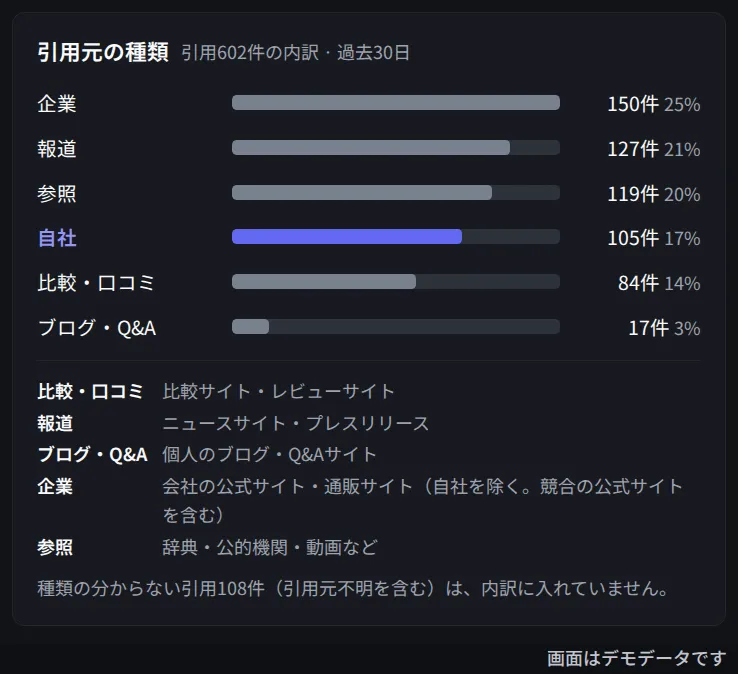
引用元は、比較・口コミ、報道、ブログ・Q&A、企業、参照の5つの種類に分けて数えます。
指標の体系
5つの見え方(AI別・取得方法別)
ひとつの総合点にまとめず、意味の違う5つの見え方に分けて表示します。見え方ごとに、どのAIで・どの取得方法で計測したかもわかります。
| 見え方 | かんたんな言い方 | 見ているもの |
|---|---|---|
| 被発見性 | かんたんな言い方見つけてもらえたか | 見ているものAIが外部情報を取りに行った割合と、AIクローラーが自社サイトへアクセスした記録 |
| 引用 | かんたんな言い方引用されたか | 見ているものくり返し測ったときに引用された割合。AI別・取得方法別に分けた、結果の幅と実数 |
| 卓越性 | かんたんな言い方回答のどこに出たか | 見ているもの回答の中での位置の分布(1位/2〜3位/4位以下)と中央値 |
| アーンド言及 | かんたんな言い方第三者にどれだけ語られているか | 見ているもの引用元の数・媒体の種類・最近いつ引用されたか。傾向を見るもので、原因と結果の関係を示すものではありません |
| 安定性 | かんたんな言い方測り直しても同じか | 見ているものくり返しや週をまたいだときに、引用元の顔ぶれがどれだけ一致するか |
- 5つをまとめた値も表示します。ただし、重みをつけて合成した参考値として扱い、判断の主な材料にはしません。
- どの見え方を計算に入れたかは、値の近くに書きます。
- 含めた見え方が違う値どうしは、比べたり時系列でつなげたりしません。
- 計測できなかった見え方は「計測対象外」と表示し、0としては扱いません。
診断の考え方
AIが本文を読み取れるかの採点
自動チェック4項目と、AIによる参考値2項目で採点します。参考値は分けて表示します。
自動チェック4項目と、AIによる採点2項目(参考値)
AIが本文と構造をどこまで取り出せるかを採点します。主にするのは、自動で判定できる項目です。文意の読み取りが必要な項目は、AIによる参考値として分けて表示します。点数は引用のされやすさを保証するものではありません。
ページ構造スコア(GEO-SFE)
ページ構造の5つの特徴から、ルールで採点します。AIを使わないため、同じページには常に同じ点が出ます。
正直さの原則
データ不足のときは、データ不足と表示する
すべてのダッシュボードに適用する原則です。
計測データが判定に足りないとき、Geo Index は勝ち負けや傾向を無理に出しません。「データ不足」とそのまま表示します。見栄えの良い数字よりも、あとから確かめられる数字を優先します。
記録の保存
AIへの問い合わせを記録する
AIへの問い合わせはすべて記録し、どのプロンプト(AIへの質問文)・どのモデルで計測したかを、あとから確認できます。
施策の計画は、結果より先に記録する
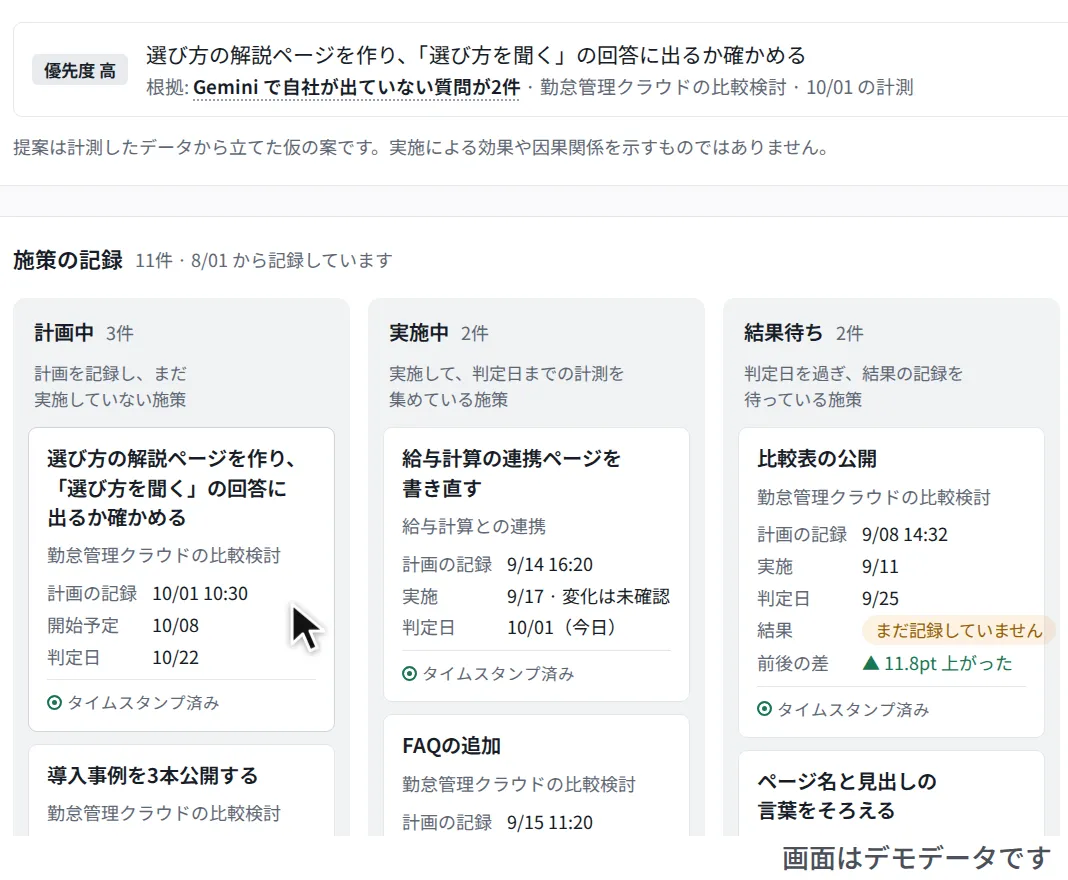
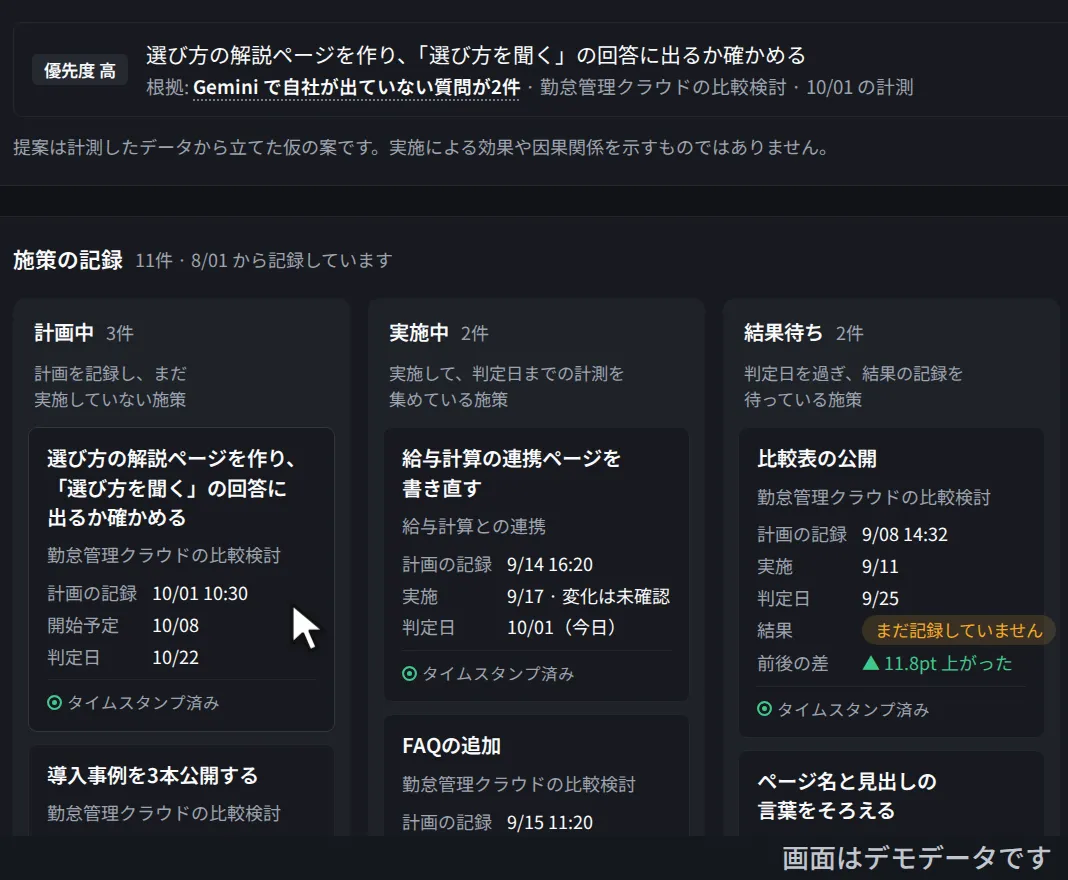
施策を始める前に、計画と開始予定日を記録できます。記録した日時が残るので、計画を結果より前に立てたことをあとから確かめられます。
くり返し計測
傾向をつかむ計測と、8回くり返す計測
AIの回答は1回ごとにぶれるため、同じ質問をくり返して測ります。2つの方法の違いを図にしました。
広さ優先の計測
提供中質問の数を優先し、くり返しは最大2回にとどめて傾向をつかみます。
8回くり返す計測
提供中同じ質問を8回くり返し、何回中何回引用されたか(例: 8回中3回)と結果の幅を示す方法です。計画・完了・失敗した回数もあわせて表示します。
丸の数は、同じ質問をくり返す回数(最大)を表します。くり返す理由と限界は、次の章に書きます。
根拠と限界
根拠と限界(当社に不利な事実も含めて)
ここでは、当社の計測方法の根拠と、分かっている限界を、当社に不利な事実も含めて書きます。限界を先に示す構成は、Ahrefs Brand Radar methodologyの「Transparency and limitations」の章にならいました。
この章は、計測の設計を詳しく確かめたい方向けです。
既知の限界(先に示します)
- くり返し計測のn=8は「分布の安定」を保証する数ではありません。Graphiteの研究(2026年4月)は、素早い推定には各プロンプト10回以上の計測を推奨しています。10回の回答では、98.6%のプロンプトが平均の誤差(平均絶対誤差)10%以下になったと報告しています。
- くり返しを増やしても、ぶれの減り方は次第に小さくなります(反復の追加には限界効用の逓減があります)。Żatuchin(2026, arXiv:2607.13304)は、5回目以降にくり返しを1回増やしても、相対誤差のばらつきは0.0003しか減らないと報告しています。中東欧20ブランド・8言語・評判の傾向を対象とした研究のため、引用計測一般への外挿には限界があります。
- 同じ日に再実行しても、引用元の一致度(Jaccard係数)は0.32〜0.43にとどまります(Schulte et al. 2026, arXiv:2604.07585)。1回だけの計測結果は、時間の経過よりも、その日ごとの偶然に大きく左右されます。
- 無料プラン(1週間に15クレジット)は、IABの基準では「探索的」(プロンプト50件未満)に当たり、判断に使う設計ではありません。
- 広さ優先の計測はくり返しが最大2回なので、1回ごとの偶然の影響を受けやすく、結果の幅も広くなります。幅は結果とあわせてそのまま表示します。
同じ質問を8回くり返す理由
Schulte et al.(2026, arXiv:2604.07585)は、AI検索の回答が計測ごと・プロンプトごと・時期ごとに変わると報告しました。1回の観測ではとらえきれないため、くり返し測って結果のばらつきごと見る必要があると示しています。同論文が n=8 という数を指定しているわけではありません。また、IABの基準も固定のくり返し回数を要求せず、プロンプトあたりの回答数と、一貫性の判定方法を公開するよう求めています。
くり返し計測のn=8は、この知見をふまえた当社の設計判断です(統計的な検出しやすさと計測コストのつり合い)。回数を増やすと(例: Graphiteが推奨する10回以上)結果の幅はさらに狭くなります。当社は、計画・完了・失敗したくり返し回数と結果の幅(下限%〜上限%。95%区間をウィルソン法で求めます)を常に表示し、判断の材料をお客様に渡します。回数そのものを正しい数として押しつけません。広さ優先の計測(n≤2)は傾向をつかむためのもので、幅が広いこともそのまま表示します。
結果がぶれる3つの原因
結果のばらつきは、説明のために3つに分けています。(1)同じ条件でも回答が変わる、同じ日のぶれ。(2)聞き方(プロンプトの言い回し)によるぶれ。(3)モデル更新や情勢の変化による、時間のぶれ。Żatuchin(2026)が評判の傾向を対象に分けた例では、(1)がばらつき全体の34.8%、質問の言語が26.5%を占めました。Schulte et al.(2026)では、45〜46日の期間で見た引用元の一致度(0.34〜0.42)が、同じ日に再計測したとき(0.32〜0.43)とほぼ同じでした。短期のぶれは、時間による変化よりも、その日ごとの偶然が大きいと読めます。比率は指標・市場・言語で変わります。そのため当社は、この3つの分け方を説明の枠組みとして使い、固定の比率は主張しません。
「計測は低頻度で十分」という見方への応答
SISTRIXの調査(82,619プロンプト・6カ国・2025年12月〜2026年4月)では、AIの回答に引用されるドメインの顔ぶれが、毎週入れ替わっていました。入れ替わりはGoogle AI Modeで約56%、ChatGPT Searchで約74%でした。Google AI Overviewsは両極端で、53%のプロンプトは17週間変わっていません。IABの基準は、1回の回答だけの計測を「計測ではない」としています。一方で、前に述べたとおり、くり返しを増やしても精度の上がり方は次第に小さくなります。当社が8回のくり返し計測と、最大2回の広さ優先の計測を組み合わせる設計にしたのは、この両方の事実をふまえたためです。
出典
- IAB, Measuring Visibility in the AI Era(2026年8月)
https://www.iab.com/guidelines/measuring-visibility-in-the-ai-era/
- Schulte et al., Don't Measure Once: Measuring Visibility in AI Search(2026)
https://arxiv.org/abs/2604.07585
- Żatuchin, Where Does the Noise Come From?(2026)
https://arxiv.org/abs/2607.13304
- Graphite, Demystifying Randomness in AI(2026年4月)
https://graphite.io/five-percent/research/demystifying-randomness-in-ai
- SISTRIX, AI Citation Drift(2026)
https://www.sistrix.com/blog/ai-citation-drift-how-stable-are-sources-in-ai-search-results/
- Ahrefs, Brand Radar Methodology
https://ahrefs.com/blog/brand-radar-methodology/
外部の研究・調査への言及は、その時点で公開されていた内容の要約です。当社サービスの効果を示すものではありません。参照日: 2026年8月25日。
業界基準への対応
業界団体IABの基準に、どこまで対応しているか
基準が求める項目への対応を、当社自身が3段階で評価しています。第三者の審査を受けたものではありません。
- 求められる項目(8項目)
- 対応済み 2・一部対応 5・未対応 1
- 判断に使える水準の基準(9項目)
- 対応済み 3・一部対応 5・未対応 1
関連ページ
計測の前と、そのあと
そもそもなぜ計測するのか、計測をどの順番で使うのかは、それぞれのページにまとめています。